(주)이프는 Vision Agent 같은 검사 · 제어 프로그램을 개발하면서 여러 AI 코딩 에이전트를 함께 씁니다. 이번 글은 AI 코드리뷰를 어떻게 하는지, 특히 ChatGPT(Codex) 와 Claude(Claude Code) 에게 같은 과제를 시키고 서로의 코드를 검증하게 하는 방법을 정리합니다.
설명만 하면 와닿지 않아서, 오픈소스 에이전트 관리 도구 오르카(Orca) 를 직접 설치하고 두 AI 를 연결해 처음부터 끝까지 돌려 봤습니다. 아래 화면과 숫자는 전부 그 실제 결과입니다. 시연에는 고객 정보가 섞이지 않도록 검사 판정 함수와 결과 화면만 들어 있는 작은 데모 저장소를 따로 만들어 썼습니다.
오르카가 하는 일 한 줄 요약
여러 AI 코딩 에이전트를 각자 격리된 작업 공간(git 워크트리) 에서 동시에 돌리고, 진행 상황과 결과(변경 내용 · 화면)를 한 창에서 비교해 더 나은 쪽을 반영하게 해 주는 데스크톱 앱입니다.
무료이고 오픈소스(MIT 라이선스)이며 윈도우 · macOS · 리눅스에서 돌아갑니다. AI 사용료를 따로 받지 않고, 이미 가입해 둔 ChatGPT · Claude 구독을 그대로 씁니다. 처음 실행하면 PC 에 설치된 에이전트를 자동으로 찾아 줍니다. 저희 PC 에서는 Claude 와 Codex 두 개를 바로 감지했고, 그 밖에 40개 이상의 에이전트를 지원합니다. 화면은 한국어로 나옵니다.
준비 : 두 AI 를 연결하기
| 항목 | 하는 일 |
|---|---|
| Claude 쪽 | Claude Code 설치 후 로그인. 오르카가 claude 명령을 찾아 연결합니다 |
| ChatGPT 쪽 | Codex CLI 설치(npm i -g @openai/codex) 후 ChatGPT 계정으로 로그인. 데스크톱 Codex 앱을 이미 쓰고 있다면 같은 로그인이 그대로 공유됩니다 |
| 오르카 | 공식 저장소에서 윈도우 설치 파일을 받아 설치. 첫 실행 마법사에서 기본 에이전트 · 테마 · 터미널 셸 · 알림을 고릅니다 |
윈도우에서 Codex 가 바로 꺼질 때
저희가 실제로 처음 부딪힌 문제입니다. 오르카의 기본 터미널이 PowerShell 이면, npm 으로 설치한 Codex 실행 스크립트가 PowerShell 실행 정책에 막혀 "이 시스템에서 스크립트를 실행할 수 없으므로…" 오류가 나고 바로 종료됩니다. 해결은 두 가지 중 하나입니다.
- 오르카 설정에서 Codex 터미널 셸을 명령 프롬프트(cmd) 나 Git Bash 로 바꾼다 (저희는 이 방법을 썼습니다)
- PowerShell 실행 정책을 현재 사용자 범위에서 완화한다. 보안 정책을 바꾸는 일이라 사내 IT 기준을 먼저 확인하세요
1단계 : 같은 과제를 두 AI 에 동시에 시키기
오르카에서 작업 하나는 워크트리 하나입니다. 같은 저장소에서 갈라져 나온 독립 작업 폴더라서, 두 AI 가 같은 파일을 동시에 고쳐도 서로 덮어쓰지 않습니다. 같은 시작점에서 워크트리를 두 개 만들고, 하나에는 Claude, 하나에는 Codex 를 붙여 똑같은 지시를 내렸습니다.
judge.js 의 judge(measurements, specs) 를 구현해 주세요.
조건:
(1) 각 항목 값이 specs[항목].min ~ max 범위 밖이면 그 항목을 defects 에 넣고 result 는 NG
(2) 값이 없거나 숫자가 아니거나 NaN 이면 조용히 넘어가지 말고
    result 를 ERROR 로 하고 defects 에 "<항목>:invalid" 를 넣을 것
(3) specs 에 없는 항목은 무시
(4) 경계값(min, max 와 같은 값)은 OK
judge.test.js 에 위 조건을 모두 검증하는 테스트를 추가하고
npm test 가 통과할 때까지 진행하세요.
검사 장비의 판정 함수를 흉내 낸 과제입니다. 조건 (2) 처럼 "결과를 못 내면 조용히 통과시키지 말고 드러내라" 는 요구는 검사 소프트웨어에서 가장 중요한 원칙이라 일부러 넣었습니다.
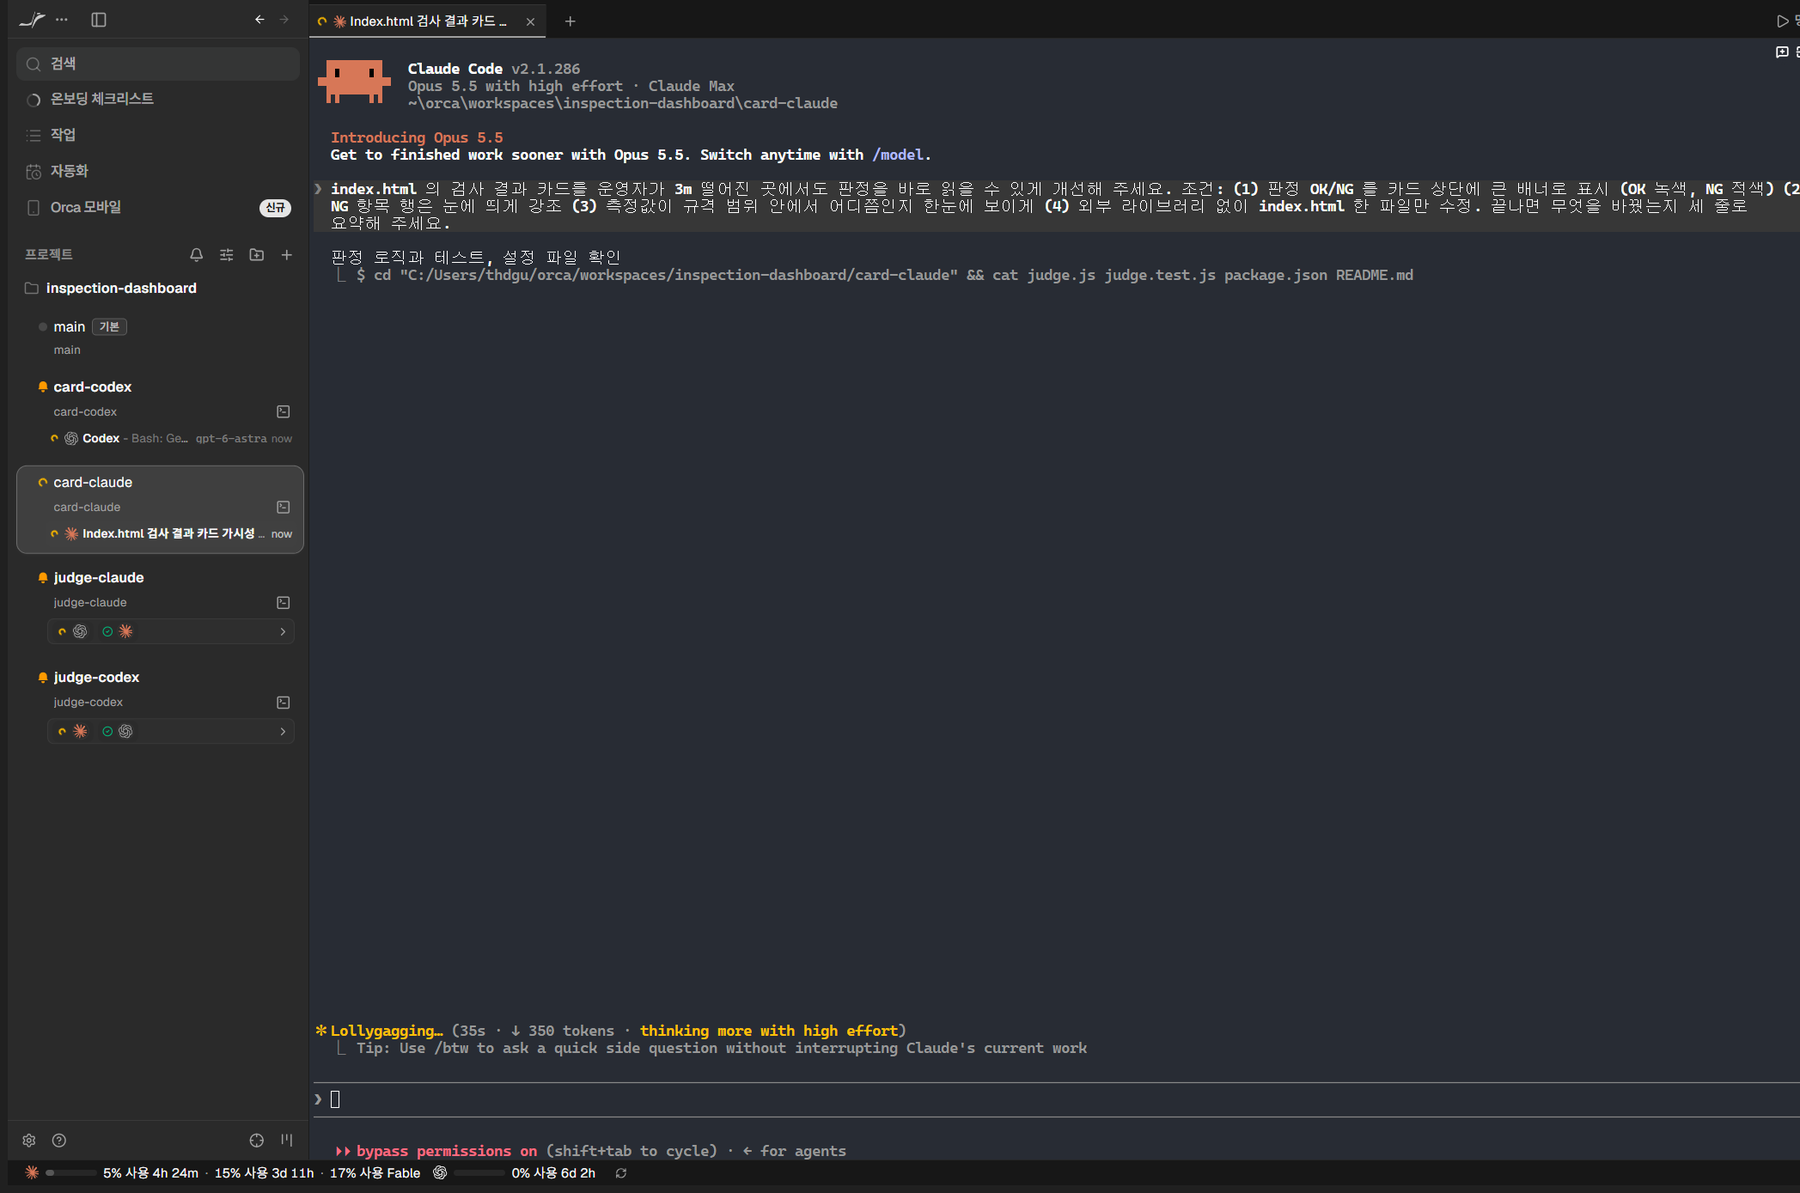
두 AI 모두 구현하고 테스트를 스스로 추가했습니다. 그리고 자기 테스트는 둘 다 100% 통과했습니다.
| 구분 | Claude | Codex |
|---|---|---|
| 스스로 만든 테스트 | 13개 · 전부 통과 | 21개 · 전부 통과 |
| 구현 방식 | 입력이 비어 있어도 대비 | 입력이 정상이라고 가정 |
여기서 끝내면 "둘 다 잘했다" 가 됩니다. 실제로는 그렇지 않았습니다.
2단계 : 서로의 코드를 검증하게 하기
각 워크트리에 작성하지 않은 쪽 AI 를 리뷰어로 하나 더 붙였습니다. Claude 가 짠 코드는 Codex 가, Codex 가 짠 코드는 Claude 가 봅니다. 핵심은 리뷰어에게 코드는 고치지 말고 검토만 하게 하고, 상대가 만든 테스트를 내 구현에 돌려 보게 한 것입니다. 이것이 서로를 시뮬레이션하는 가장 간단한 방법입니다.
이 워크트리의 judge.js 와 judge.test.js 는 다른 AI 가 작성했습니다.
코드는 수정하지 말고 리뷰만 해 주세요.
1) 요구 조건 네 가지를 만족하는지 확인
2) measurements 나 specs 가 null 또는 undefined 일 때, Infinity,
   숫자 문자열 같은 예외 입력을 node -e 로 직접 실행해 결과 확인
3) 옆 워크트리의 judge.test.js 를 임시로 복사해 이 judge.js 에 대해 실행하고
   결과를 비교한 뒤 임시 파일은 삭제
4) 발견한 문제를 심각도 순으로 표(문제 · 재현 입력 · 실제 결과 · 기대 결과)로 정리
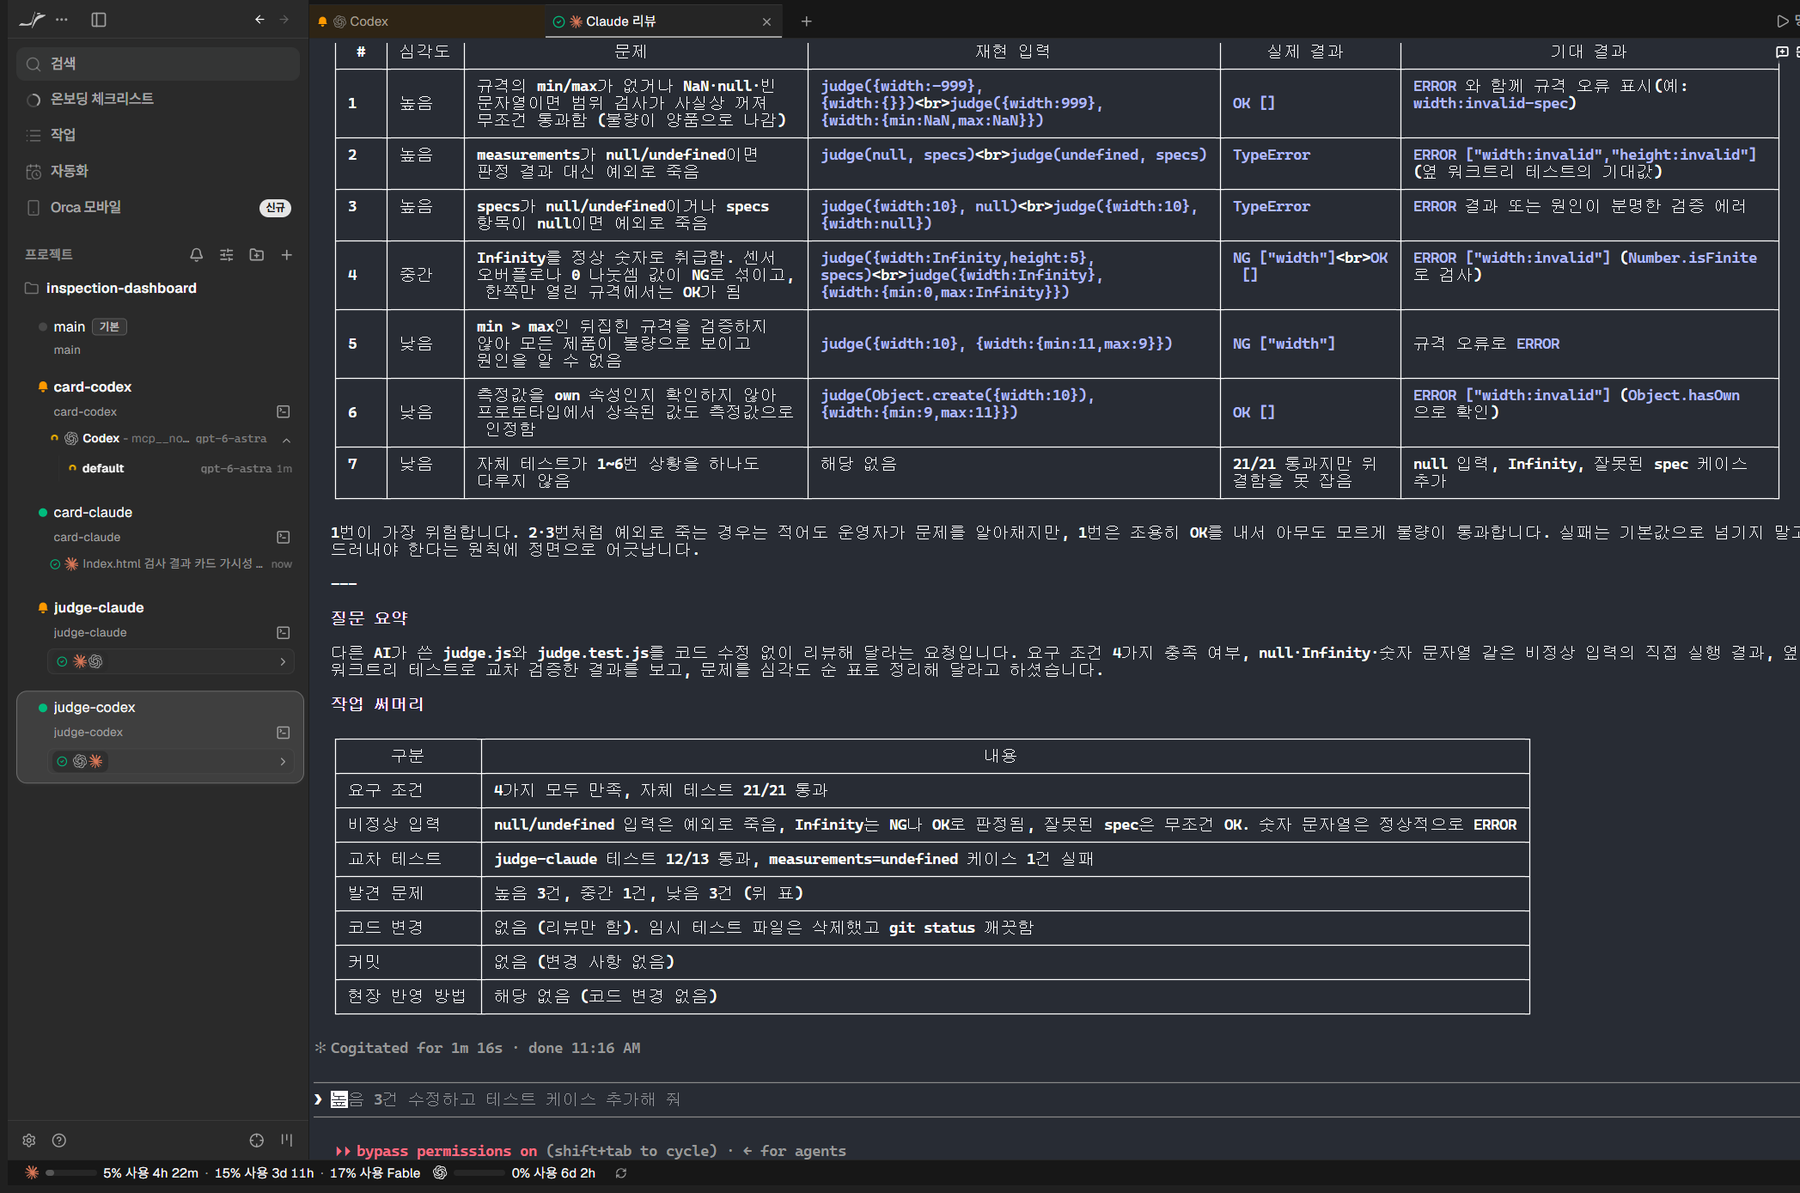
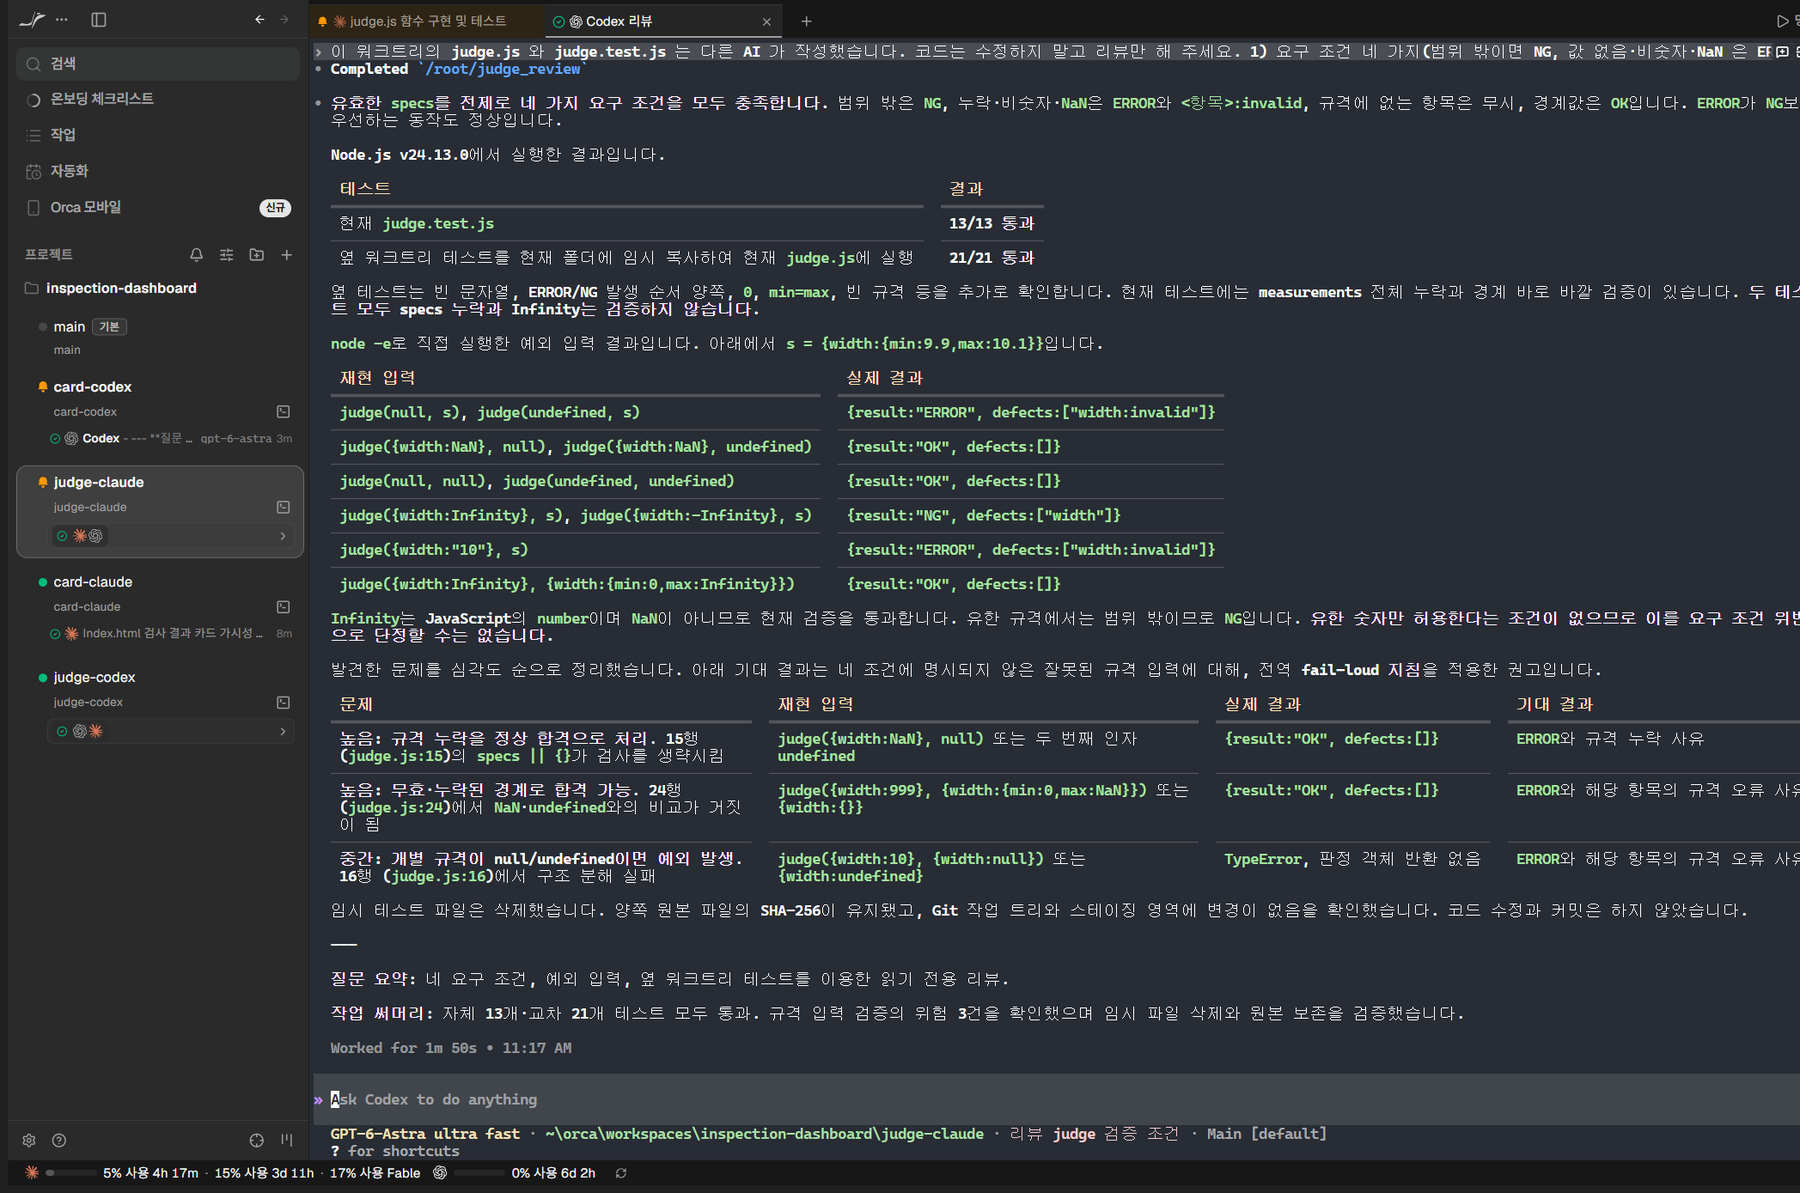
결과는 이렇게 나왔습니다.
| 확인 | 결과 |
|---|---|
| Codex 구현 + Claude 테스트 | 13개 중 12개 통과. 측정값 전체가 비어 있으면 판정 대신 예외로 멈춤 |
| Claude 구현 + Codex 테스트 | 21개 전부 통과 |
| 두 리뷰어가 공통으로 찾은 것 | 규격의 min · max 가 비거나 NaN 이면 범위 검사가 사실상 꺼져 조용히 OK 가 나옴. 불량이 양품으로 나가는 유형 |
가장 흥미로운 대목은 세 번째 줄입니다. 두 리뷰어가 서로 다른 코드에서 같은 맹점을 찾았습니다. 작성한 두 AI 는 지시받은 조건(측정값 검증)만 꼼꼼히 챙겼고, 조건에 없던 규격 쪽 검증은 둘 다 놓쳤습니다. 리뷰를 맡은 두 AI 는 조건 밖을 봤습니다.
작성자는 자기가 받은 조건만 테스트합니다. 그래서 작성자와 검증자를 나누면, 같은 맹점을 두 번 놓치지 않습니다.
3단계 : 더 나은 쪽을 고르고 리뷰를 반영하기
상대의 테스트까지 모두 통과한 Claude 구현을 채택하고, 두 리뷰어의 지적을 묶어 Claude 작성자에게 되돌렸습니다. 오르카에는 변경 내용(diff) 화면의 줄마다 코멘트를 달아 두었다가, 모은 코멘트를 원하는 에이전트에게 한 번에 보내는 기능(Send to agent)이 있습니다. 코멘트를 하나씩 보내는 것보다 묶어서 한 번에 보내야 수정이 한 흐름으로 정리됩니다. 반영 후 결과입니다.
| 항목 | 반영 전 | 반영 후 |
|---|---|---|
| 자체 테스트 | 13개 통과 | 32개 통과 |
| 상대(Codex) 테스트 | 21개 통과 | 21개 통과 유지 |
| 규격이 비거나 NaN · min > max | 조용히 OK | ERROR 로 표면화 |
| 측정값 Infinity | NG 또는 OK | ERROR 로 표면화 |
채택한 워크트리는 본 브랜치에 병합하고, 떨어진 후보 워크트리는 정리했습니다. 오르카에서는 작업 공간과 브랜치를 함께 지우는 정리 기능이 있어 흔적이 남지 않습니다.
UI · 화면 지시는 후보 두 개를 받아 고르기
코드는 테스트로 맞고 틀림을 가릴 수 있지만, 화면은 정답이 하나가 아닙니다. 이럴 때는 같은 지시로 후보를 두 개 받아 나란히 놓고 고르는 쪽이 빠릅니다. 이번에는 이렇게 지시했습니다.
index.html 의 검사 결과 카드를 운영자가 3m 떨어진 곳에서도
판정을 바로 읽을 수 있게 개선해 주세요.
(1) 판정 OK/NG 를 카드 상단에 큰 배너로 (OK 녹색, NG 적색)
(2) NG 항목 행은 눈에 띄게 강조
(3) 측정값이 규격 범위 안에서 어디쯤인지 한눈에 보이게
(4) 외부 라이브러리 없이 index.html 한 파일만 수정
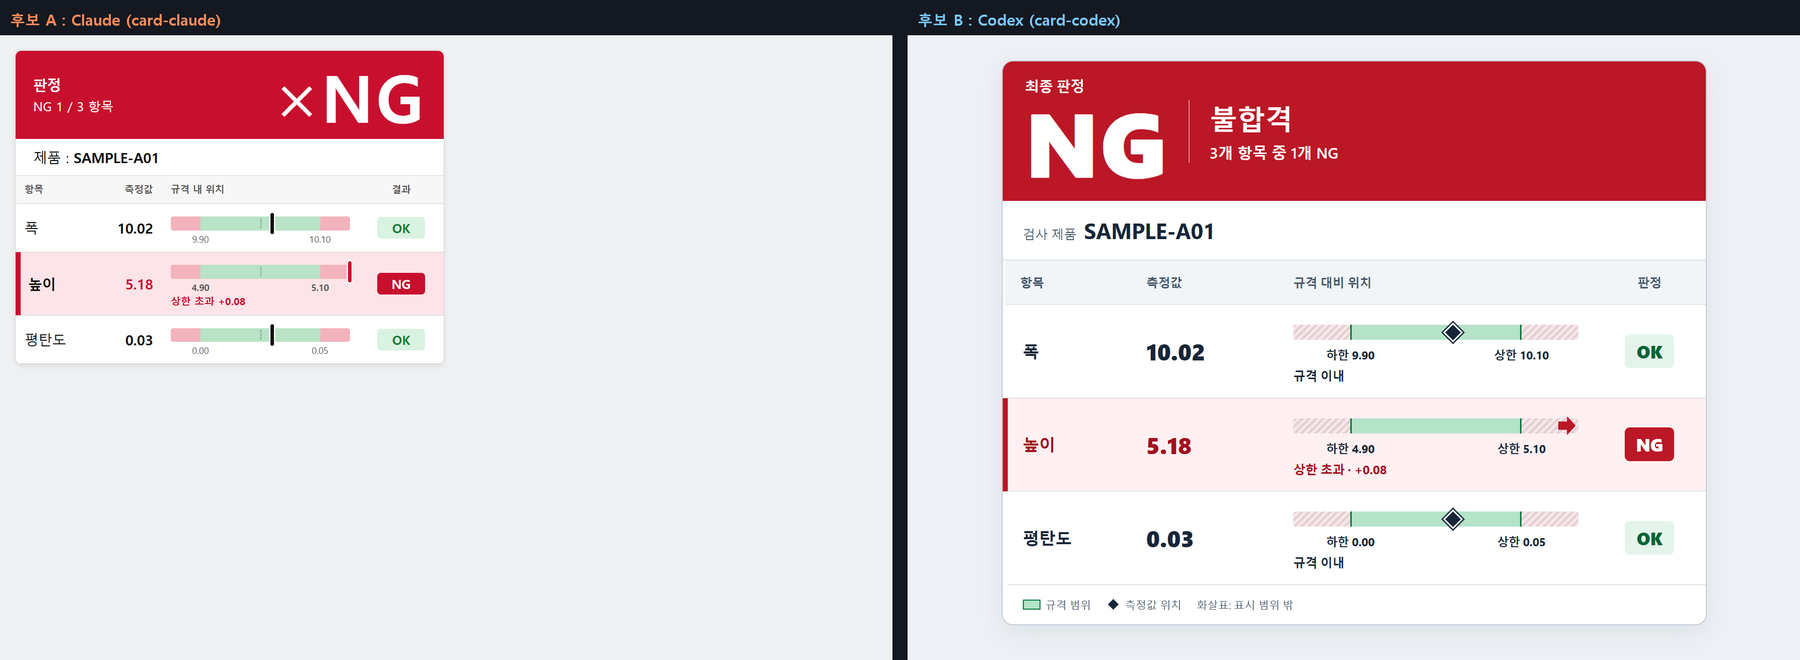
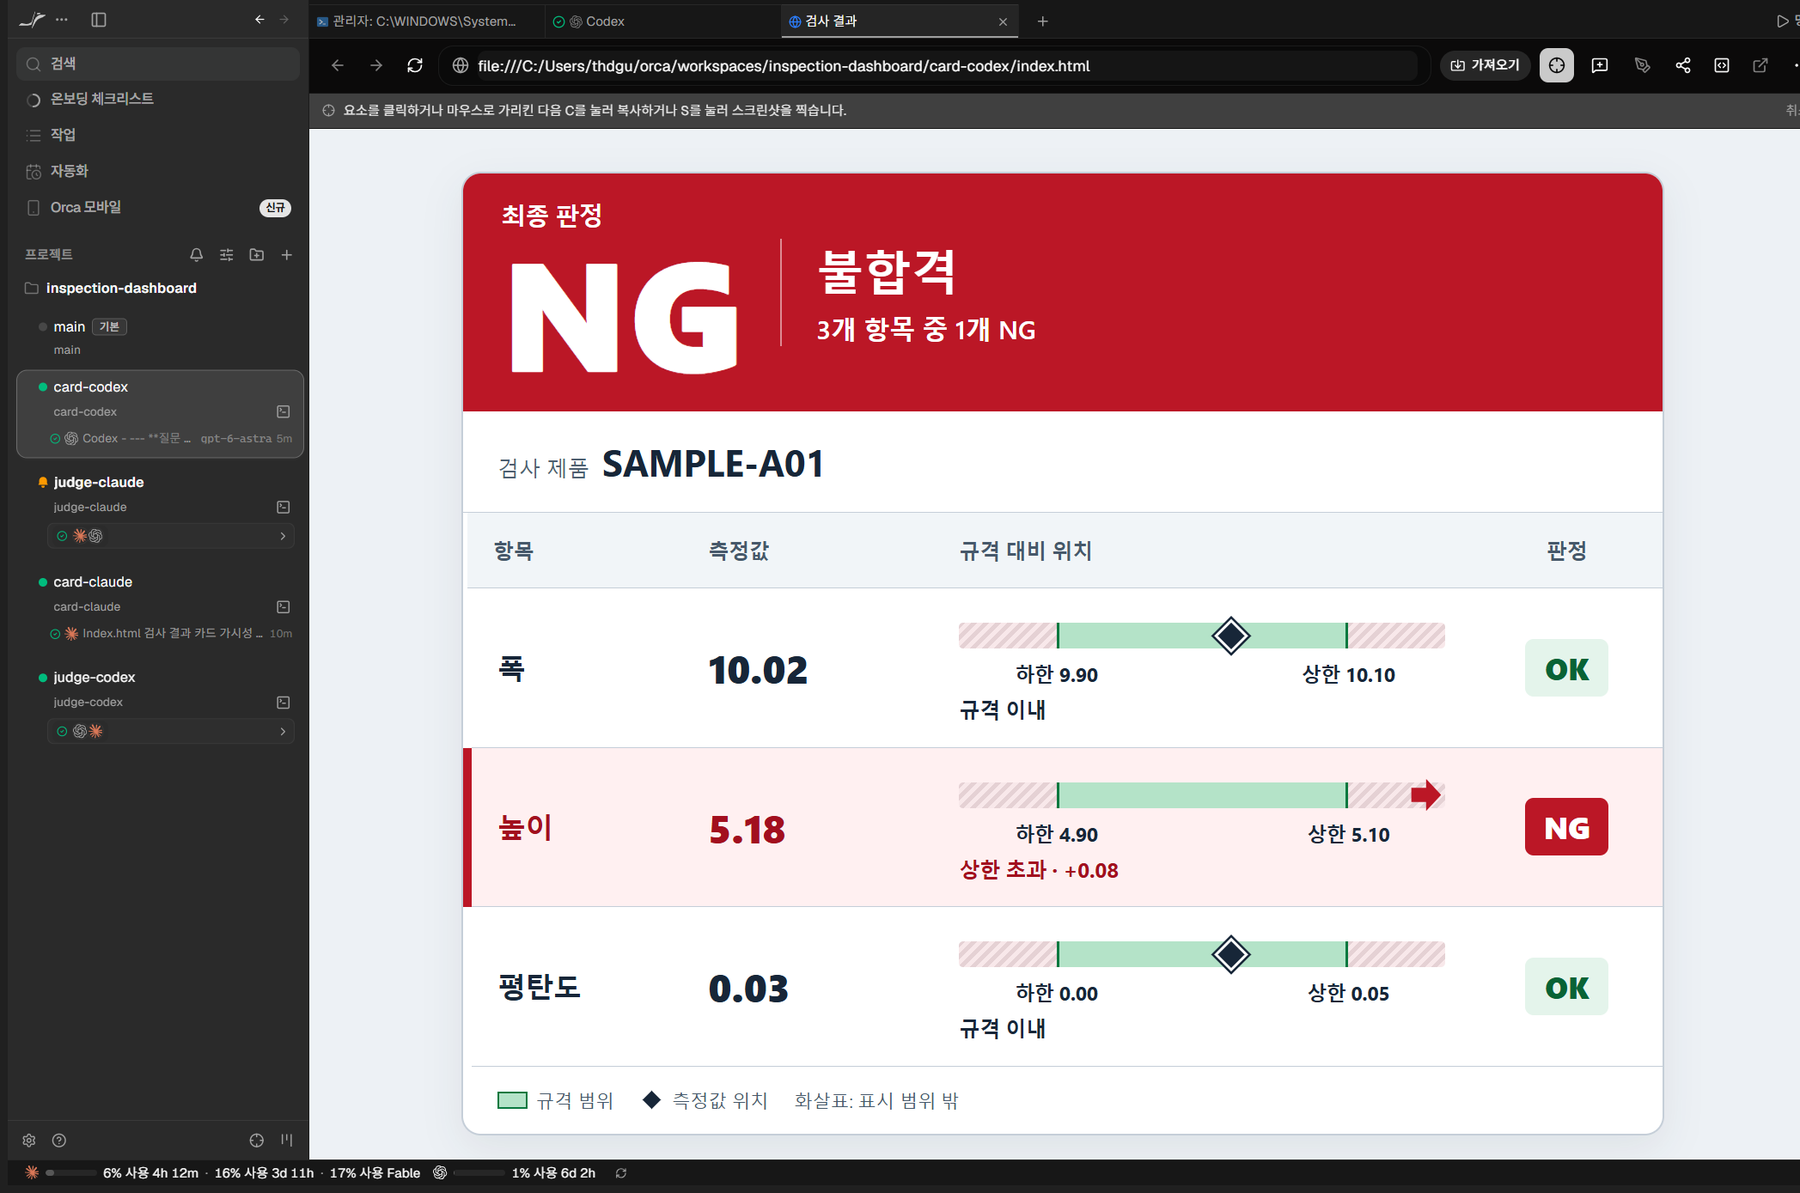
같은 지시였는데 해석이 꽤 달랐습니다. Claude 는 원래 카드 폭을 지키며 압축했고, Codex 는 카드를 키워 "NG 불합격" 을 크게 배치하고 범위 이탈을 화살표로 표시했습니다. "3m 거리에서 읽기" 라는 조건에는 후보 B 가 더 맞아서 B 를 채택했습니다. 반대로 한 화면에 카드를 여러 장 띄워야 하는 화면이었다면 A 를 골랐을 겁니다. 고르는 기준은 사람이 정합니다.
오르카는 워크트리마다 내장 브라우저가 있어서 각 후보를 앱 안에서 바로 띄워 볼 수 있습니다. 고른 화면을 조금 더 다듬을 때는 브라우저 도구 막대의 "페이지 요소 가져오기"(디자인 모드)를 켜고 고칠 부분을 클릭합니다. 그 요소의 HTML, 적용된 스타일, 잘라낸 스크린샷이 에이전트 입력창에 첨부되고, 바꾸고 싶은 내용만 말로 덧붙이면 됩니다.
정리 : AI 교차 코드리뷰 체크리스트
| 자주 하는 실수 | 이렇게 하세요 |
|---|---|
| AI 한 개에게 짜게 하고 같은 AI 에게 검토시킨다 | 작성자와 리뷰어를 다른 AI 로 나눈다 |
| 자기 테스트 통과를 완료로 본다 | 상대가 만든 테스트를 내 구현에 돌린다. 해석 차이가 바로 드러난다 |
| 리뷰어에게 고쳐 달라고 한다 | 리뷰어는 수정 없이 표로만 보고. 고치는 건 작성자에게 되돌린다 |
| 지시에 "예외 입력" 을 쓰지 않는다 | 비어 있음 · NaN · 무한대 · 뒤집힌 범위를 직접 실행해 보게 한다 |
| UI 를 한 번에 정답으로 받으려 한다 | 후보 두 개를 받아 나란히 놓고 고른다 |
| 두 AI 가 같은 폴더에서 작업한다 | 워크트리로 작업 공간을 나눈다. 서로 덮어쓰지 않는다 |
(주)이프도 실제 개발에서 이 방식을 쓰고 있습니다. 검사 소프트웨어는 "결과를 못 냈을 때 조용히 통과시키는" 결함이 가장 위험한데, 이번 시연처럼 그런 결함은 작성자 혼자서는 잘 보이지 않습니다.
다음 글에서는 오르카에 내 PC 의 프로젝트와 GitHub 저장소를 연결하는 방법을 정리하겠습니다.